 LiteSite(轻站)
Nuxt SSR(服务端渲染)做的事,是在首次请求时先运行页面组件、取得必要数据,并在服务端把 Vue 页面渲染成 HTML 发给浏览器。浏览器可以先显示内容,再加载客户端代码接管交互。理解它,最好沿着一次请求走,而不是把 SSR 简化成“服务器返回一段 HTML”。以下以 Nuxt 4 的文章详情页为例。
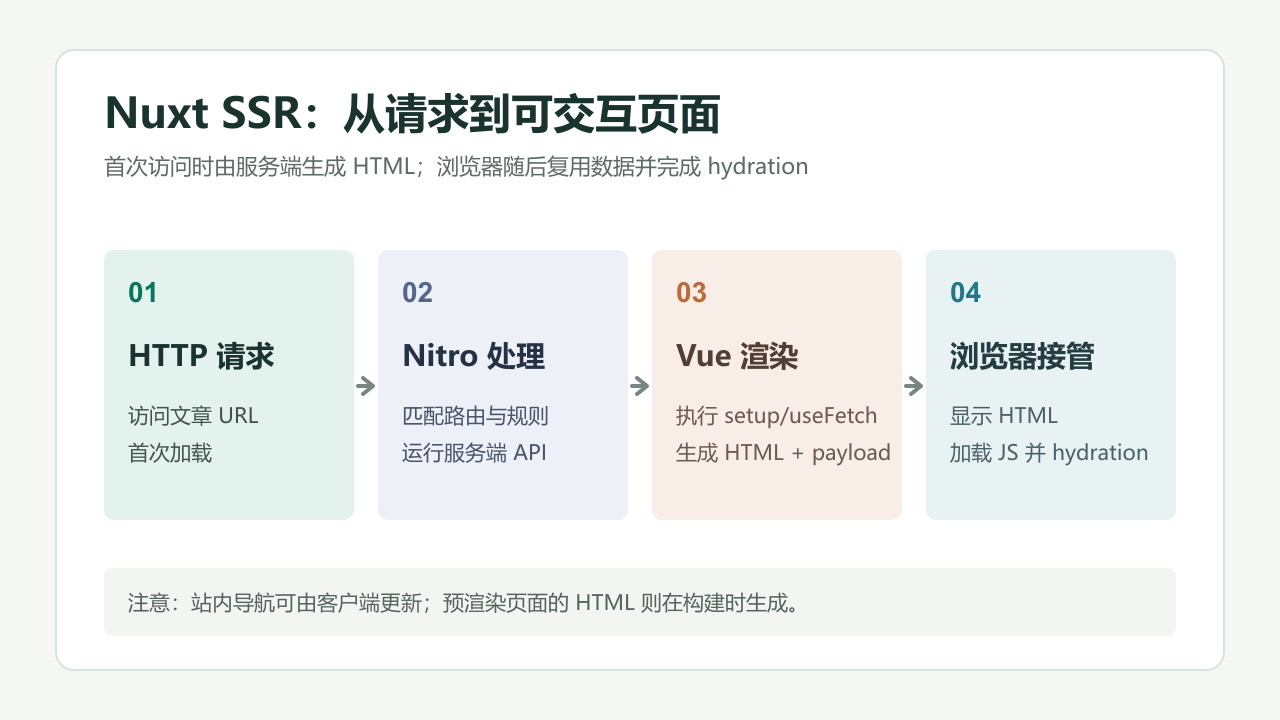
图:这是首次访问页面的主流程;站内导航和预渲染各有不同的执行时机。
第一步:请求先到 Nitro
用户直接打开 /blog/某篇文章,浏览器发出 HTTP 请求。Nuxt 的服务端运行时 Nitro 接收请求,应用路由和相关规则,再把页面交给 Nuxt 渲染。如果页面调用本站的 /api/posts/:slug,这个接口也是 Nitro 的服务端路由;它可以查询数据库并返回文章数据。
这里要分清页面请求与 API 请求:页面请求最终要产生 HTML,API 路由返回数据。Nuxt 能把这两者放在同一项目里,但权限和缓存边界仍要单独设计。本博客公开文章走可公开的数据读取,后台草稿则不能被共享缓存或匿名请求泄露。
第二步:服务端执行页面的 setup 和数据获取
Nuxt 为这次请求创建渲染上下文,匹配页面组件并执行其 setup。文章页可以这样写一个简化版本:
<script setup lang="ts">
const route = useRoute()
const { data: post, error } = await useFetch(
  () => '/api/posts/' + route.params.slug
)
if (error.value) {
  throw createError({ statusCode: error.value.statusCode || 500 })
}
</script>

<template>
  <article v-if="post">
    <h1>{{ post.title }}</h1>
    <p>{{ post.summary }}</p>
  </article>
</template>
在首次服务端渲染中,Nuxt 等待这个异步数据操作完成,随后把文章标题和摘要写进返回的 HTML。使用 useFetch 或 useAsyncData 的另一个关键点是:结果会进入 Nuxt 的 payload,供浏览器启动时复用。实际本站的文章详情页也使用了 await useFetch 来读取按 slug 查询的文章。
如果只在 onMounted 中请求数据,服务端不会执行那段逻辑,首份 HTML 里通常没有文章正文。直接在页面 setup 中用普通 $fetch 虽然能在服务端拿到数据,却可能在客户端初始化时重复请求;面向页面状态时优先用 Nuxt 的异步数据 API。
第三步:返回 HTML,也带上可复用的数据
服务端根据组件状态生成 HTML,同时输出页面所需的头部信息、资源链接和序列化的数据 payload。浏览器收到响应后,即使 JavaScript 还没完成加载,也可以解析并展示已有的标题、正文等内容。这有利于首屏内容呈现和需要读取 HTML 的访问者,但并不自动保证页面快或搜索排名高:数据库响应、服务端计算和网络传输仍会影响等待时间。
不要把包含用户私人信息的 HTML 或 payload 放进公共缓存。只有对所有访问者都相同的响应,才适合按公开页面的方式共享缓存。
第四步:浏览器 Hydration 接管交互
客户端 JavaScript 加载后,Vue 会依据相同的组件结构和 payload 对已有 HTML 做 hydration:复用服务端输出的 DOM,挂上事件处理,并继续维护响应式状态。因为首屏数据已在 payload 中,正常情况下不必为了同一份数据再请求一次。随后点击 NuxtLink 进入其他页面时,通常由客户端路由更新视图和按需取数,不会每次都重新下载整份 HTML 文档。
若服务端和浏览器首次计算出的内容不同,会出现 hydration mismatch。例如在渲染阶段直接使用随机数、当前时间、window 或 localStorage,可能让两端产生不同输出。浏览器专属逻辑放在 onMounted 中,或把需要一致的值在服务端算好并通过数据传给客户端。
SSR 与预渲染不是一回事
SSR 通常在请求到来时生成 HTML;预渲染在构建时就生成 HTML 文件,访问时直接返回它。本站的配置允许构建工具发现并预渲染公开文章页,而后台和 API 路由被排除在静态预渲染之外。因此部署方式很关键:如果只托管静态文件,依赖 Nitro 的实时后台与 API 仍需另有服务。
二者都能让首份响应包含内容,但数据更新时机不同。经常变化或按用户变化的页面,需要实时服务端处理或其他合适的数据更新策略;相对稳定的公开文章可以考虑预渲染与缓存。
怎么确认 SSR 真正生效
直接请求文章 URL,查看响应的原始 HTML 中是否已经有标题和正文;再看浏览器控制台是否有 hydration 警告、网络面板是否无故重复拉取首屏数据。最后测试关闭 JavaScript 后的可读内容,以及从站内链接进入同一文章时的数据加载。若两种入口表现不同,就分别检查服务端数据获取与客户端导航逻辑。
Nuxt SSR 的核心链路可以概括为:请求进入 Nitro,页面在服务端取得数据并渲染 HTML,payload 把状态带到浏览器,Hydration 接管交互。把这四步和预渲染、客户端导航分清,才能正确排查“首屏空白”“重复请求”和“服务端正常、浏览器报错”等常见问题。
评论 0
暂无评论,来说两句吧。