 LiteSite(轻站)
GEO 的技术链路怎么设计?我会把它当成一套“内容证据的发布与反馈系统”:用真实业务问题组织内容,让公开页面稳定、可核查,再用固定样本观察外部 AI 回答并修正错误。这里不能把外部 AI 的检索和生成过程画成自家可控的服务;不同产品的索引、检索和引用机制并不相同,也不会因为接入某个接口就保证收录或引用。
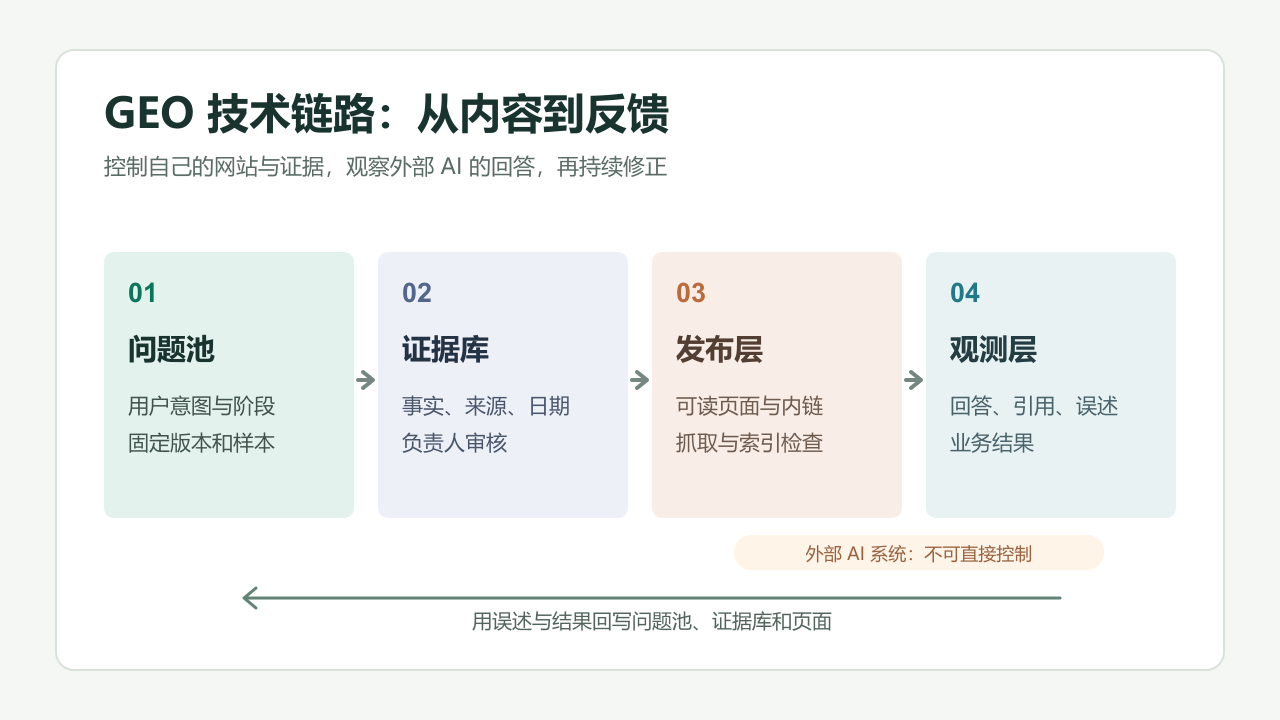
图:前三层主要由站点团队负责;外部 AI 如何使用页面只能通过合规采样观察。
先划边界:控制发布,观察回答
自有系统能控制问题选择、事实审核、页面内容、技术可访问性和日志;能观测公开回答中的提及、引用、误述,以及部分引荐与线索。外部平台是否抓取、何时更新索引、如何选取证据、最终怎样措辞,都不能直接保证。因此设计目标不是“让模型按我们的流程回答”,而是让正确资料容易找到、容易理解、容易核对,且发现问题后能快速修订。
如果团队另有自建 RAG 助手,那套系统可以控制切块、向量检索和生成提示。但自建助手的命中率不能直接代表外部 AI 产品中的 GEO 表现,两者应分开监测。
第一层:版本化的问题池
先从咨询、销售和站内搜索中整理问题,按用户意图与决策阶段归类。每条问题至少记录:问题 ID、原文、语言与地区、品牌词或非品牌词、用户阶段、来源、负责人和版本。问题池要同时包含“是什么”“怎么选”“风险是什么”等不同类型,避免只测品牌名。
一组问题发布为固定版本后,后续评估尽量沿用同样的题目与运行条件。新增问题另开版本,避免把样本变化误看成内容成效。抽样时不要上传客户原始对话或个人资料;先去标识化,再保留能表达意图的问法。
第二层:可追溯的证据库
把需要对外陈述的关键事实独立管理,而不是散落在多篇文章里。每条证据记录主张、来源链接或内部依据、适用范围、生效与复核日期、业务负责人、审核状态,以及引用它的页面。价格、功能边界、交付周期、案例数据尤其需要明确负责人。
以“网站改版会不会影响原有流量”为例,页面可以解释风险条件和检查步骤;如果要写某客户的具体改善数字,就必须找到授权案例和统计口径。证据过期或被撤回时,应能定位所有相关页面,及时修订,不靠编辑逐篇回忆。
第三层:把证据发布为可读页面
以 Nuxt + Supabase 站点为例,内容仍由文章系统管理;发布时做一组自动检查:页面返回正常状态码,主要答案在服务端可读的 HTML 中,标题和摘要准确,canonical 指向正式地址,站点地图包含应公开的 URL,robots 与 noindex 没有误拦截,站内链接可用。改版时保留旧 URL 的重定向关系。
结构化数据只能描述页面上真实可见的信息。页面最好直接回答一个主要问题,再写适用条件、步骤、例外和证据来源;相关主题用自然的内链串起来。不要把隐藏文本、关键词堆砌或某个实验性文件当作“被 AI 引用”的保证。
可把发布流程做成四步:编辑提交 → 事实审核 → 页面发布 → 发布后抓取检查。最后一步用实际 URL 验证,而不是只看 CMS 显示“已发布”。对关键页面保存前后版本,出现错误时能回退。
第四层:答案采样与质量判定
定时用固定问题集检查目标平台,记录平台名称、可见的模型或版本、时间、语言、问题版本、回答文本、引用 URL、运行失败原因。采样方式应使用平台允许的接口或人工核查,并遵守其使用规则。每个问题重复运行几次,才能看出答案的波动;原始回答与人工判定要留存,方便复核。
自动规则可以初筛“是否提及品牌”“是否引用自有域名”,但“引用是否支持关键说法”“是否把能力或价格说错”需要人工抽查。统计时使用同一套分母和规则;具体公式可参考《GEO 的核心指标你怎么理解?怎么算?》。引用错误率、失效链接和关键事实误述,应比单纯提及次数更早进入告警列表。
最后用反馈推动修订
观测结果要能落到具体动作:没有被提及时,检查问题覆盖、页面入口和可访问性;被引用但说错时,核对证据、过期页面与相互冲突的表述;有访问却没有有效咨询时,再看落地页是否回答了下一步问题。修改后记录页面版本与时间,等待足够的再观察窗口,不假设外部平台会立即更新。
最小实现不需要复杂平台:一份版本化问题表、一份证据清单、现有文章 CMS、发布后页面检查任务、定期答案采样记录和一张人工复核看板就够了。先让“哪条主张来自哪里、发布在哪页、被怎样引用、谁负责修正”能够追踪,再逐步自动化。GEO 技术链路的价值,正是把内容生产变成可审计、可维护的循环。
评论 0
暂无评论,来说两句吧。